Este proyecto es el entrenamiento de un robot de minisumo usando aprendizaje por refuerzo, la idea es que el robot aprenda por si solo a sacar a su rival del circulo, en vez de programarle a mano la estrategia. Para esto simule el combate en MuJoCo y entrene las politicas con Stable-Baselines3, al final se comparo su performance contra los metodos clasicos que normalmente se usan en minisumo, como por ejemplo maquina de estados, PID, logica difusa y diferentes estrategias de ataque.
Como funciona el aprendizaje por refuerzo
La idea del aprendizaje por refuerzo es tener un agente que observa un ambiente, toma acciones y recibe una recompensa, este va ajustando su comportamiento para maximizar la recompensa acumulada. El algoritmo se podria formalizar como un proceso de decision de Markov (MDP), donde en cada paso hay un estado \(s\), una accion \(a\), una transicion al siguiente estado y una recompensa \(r\), con un factor de descuento \(\gamma\) que le da menos peso a las recompensas muy lejanas en el tiempo.
En este proyecto:
- el estado es una captura de 19 variables en un momento
- las acciones son los 7 posibles movimientos que puede hacer el robot,
- la recompensa es un valor que aumenta o disminuye segun se acerque a cumplir su objetivo
- y el ambiente es la simulacion de MuJoCo.
Para aprender la politica use dos algoritmos de la libreria Stable-Baselines3:
- DQN (basado en valor): aprende una funcion \(Q(s,a)\) que estima que tan buena es cada accion en cada estado, y se apoya en una red objetivo y en un buffer de experiencias para estabilizar el aprendizaje.
- PPO (basado en politica): ajusta directamente la politica con una actualizacion recortada, para no dar pasos demasiado grandes que rompan el entrenamiento.
A ambos los entrene con self-play, osea que el rival de cada entrenamiento es una version anterior del mismo agente, para que la dificultad vaya subiendo sola.
Problema
Un robot minisumo en un competencia consiste en un robot pequeño, de alrededor de 15x15cm, el cual armado con motores tiene como objetivo sacar al contrincante del area limitada para la competencia, el robot debe de cumplir esto empujando al contrincante hacia el borde de ring.
El robot
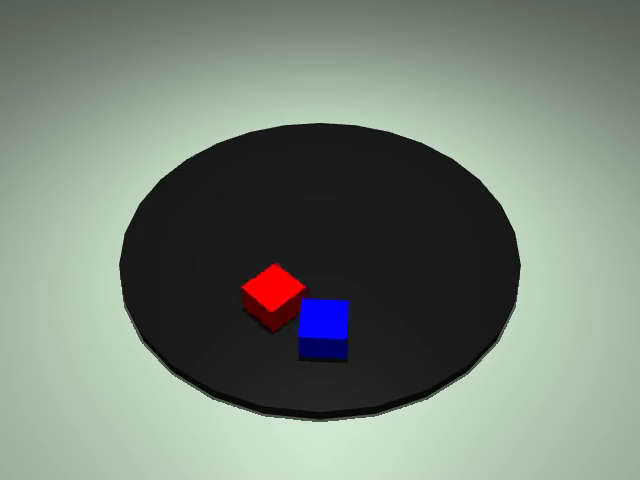
Para lograr esto se simulo un escenario, el cual es una arena circular con dos robots cuadrados que se empujan. Lo defini con un XML de MuJoCo, para mantenerlo sencillo cada robot es una caja de masa 2 con dos articulaciones de traslacion y una de rotacion. En Mujoco se definio asi el robot:
<mujoco model="minisumo">
    <compiler angle="degree" coordinate="local"/>
    <option gravity="0 0 -9.81" timestep="0.01"/>
    <worldbody>
        <geom type="plane" size="5 5 0.1" rgba="0.8 0.9 0.8 1"/>
        <geom name="arena" type="cylinder" size="1.0 0.05" pos="0 0 0.01" rgba="0.1 0.1 0.1 1"/>
        <body name="agente1" pos="0 0 0.1">
            <joint name="a1_x" type="slide" axis="1 0 0" damping="1.5"/>
            <joint name="a1_y" type="slide" axis="0 1 0" damping="1.5"/>
            <joint name="a1_z" type="hinge" axis="0 0 1" damping="5"/>
            <geom name="geom_a1" type="box" size="0.1 0.1 0.1" rgba="1 0 0 1" mass="2"/>
        </body>
        <body name="agente2" pos="0 0 0.1">
            <joint name="a2_x" type="slide" axis="1 0 0" damping="1.5"/>
            <joint name="a2_y" type="slide" axis="0 1 0" damping="1.5"/>
            <joint name="a2_z" type="hinge" axis="0 0 1" damping="5"/>
            <geom name="geom_a2" type="box" size="0.1 0.1 0.1" rgba="0 0 1 1" mass="2"/>
        </body>
    </worldbody>
</mujoco>
Entorno
Durante el entrenmiento, note que podria haber un sobreajuste a ciertas condiciones iniciales, pare evitar que la politica se sobreajustara a una sola situacion en cada episodio aleatorizo lo siguiente:
- el radio de la arena (0.7 a 1.3),
- la **posicion
- la orientacion** de aparicion,
- la fuerza de los motores (entre 180 y 320)
Durante la evaluacion de los modelos note que el robot tenia un buen desempeño al inicio y en el middle game, pero fallaba mucho al final de la competencia, justo al momento de elimiar al contrincante, por esto se agrego en el entrenamiento que hubiera una probabilidad del 50% de que el episodio arranque en un “endgame”, osea con el rival ya pegado al borde y los dos en contacto, para practicar escenarios finales.
El control no es paso a paso, uso un frame skip de 4 (cada decision del agente se repite 4 pasos fisicos de MuJoCo), y el combate dura hasta 2000 decisiones o hasta que alguien sale.
Los modelos
Para el control de un robot existen vairos modelos de aprendizaje por refuerzo, en este caso se escojieron dos que son los mas comunes
DQN
PPO
Significa Proximity Policy Aproximation
Observacion y acciones
La observacion son 19 valores normalizados, todos desde el punto de vista del robot:
$$ o = [, x,; y,; \sin\theta,; \cos\theta,; v_{avance},; v_{lateral},; v_{\theta},; \sin\phi,; \cos\phi,; \text{detecta},; d_{sensor},; d_{borde},; \text{one-hot}(a_{prev}) ,] $$
- La posicion y las velocidades van normalizadas, y las velocidades las pase al marco del robot (avance y lateral) en vez del marco del mundo.
- El angulo va como
sin/cosporque elqposde una articulacion hinge no se envuelve y puede crecer mas alla de (\pm\pi). - El robot lleva un sensor de distancia frontal con un cono de ±45°, solo ve al rival si lo esta apuntando (
detecta), y si no lo ve el sensor devuelve el maximo. - (d_{borde} = \frac{R - d_{centro}}{R}) es el margen hasta el borde (positivo si esta dentro); este dato lo agregue despues porque me di cuenta que los metodos clasicos sabian donde estaba el borde y la red no, porque el radio cambia en cada episodio.
- La accion previa va como one-hot para que la politica pueda evitar cambiar de accion y no zigzaguear.
Las acciones son 7:
| # | Accion | Motores |
|---|---|---|
| 0 | Adelante | [1.0, 1.0] |
| 1 | Giro izquierda fuerte | [-0.6, 0.6] |
| 2 | Giro derecha fuerte | [0.6, -0.6] |
| 3 | Atras | [-1.0, -1.0] |
| 4 | Parar | [0.0, 0.0] |
| 5 | Giro izquierda suave | [-0.2, 0.2] |
| 6 | Giro derecha suave | [0.2, -0.2] |
Los giros suaves los agregue porque con los giros fuertes cualquier correccion rompia la alineacion y producia zigzag.
La recompensa
Al principio usaba recompensas como + en_dist * 5
en cada paso, pero eso era un desastre porque el
agente podia farmear puntos nada mas existiendo y
le daba igual ganar. Lo cambie por shaping
basado en potencial (Ng et al., 1999),
que no cambia la politica optima y no se puede farmear:
$$ r_t = \gamma,\Phi(s’) - \Phi(s) - c_{paso} - c_{cambio} + r_{terminal} $$
$$ \Phi(s) = \left(\frac{d_{rival}}{R}\right)^{2} - \left(\frac{d_{propia}}{R}\right)^{2} $$
- El potencial es cuadratico, osea crece mas rapido cerca del borde, para que el ultimo empujon valga mas que empujar en el centro (antes era lineal y al final la señal se aplanaba y no terminaba de sacar al rival).
- (\gamma = 0.995) (subi de (0.99)) para que valore mas cerrar el combate.
- El terminal es (+2) ganar, (-2) perder y (0) empate (si salen los dos al mismo tiempo cuenta como empate).
- Hay un costo por paso de (0.001), una pena por cambiar de accion de (0.02) (anti-zigzag) y un bonus chiquito por detectar al rival.
- No hay penalizacion por zona de peligro propia (la revise porque podia estar haciendolo retroceder justo cuando debia empujar).
El algoritmo genetico
En vez de un solo modelo haciendo self-play, use un algoritmo evolutivo donde entreno varios modelos al mismo tiempo. La poblacion es de 20 modelos = 40 robots en paralelo (10 con DQN y 10 con PPO), cada uno entrena en su propio proceso. El rival de cada entrenamiento se saca al azar de un pool de versiones anteriores.
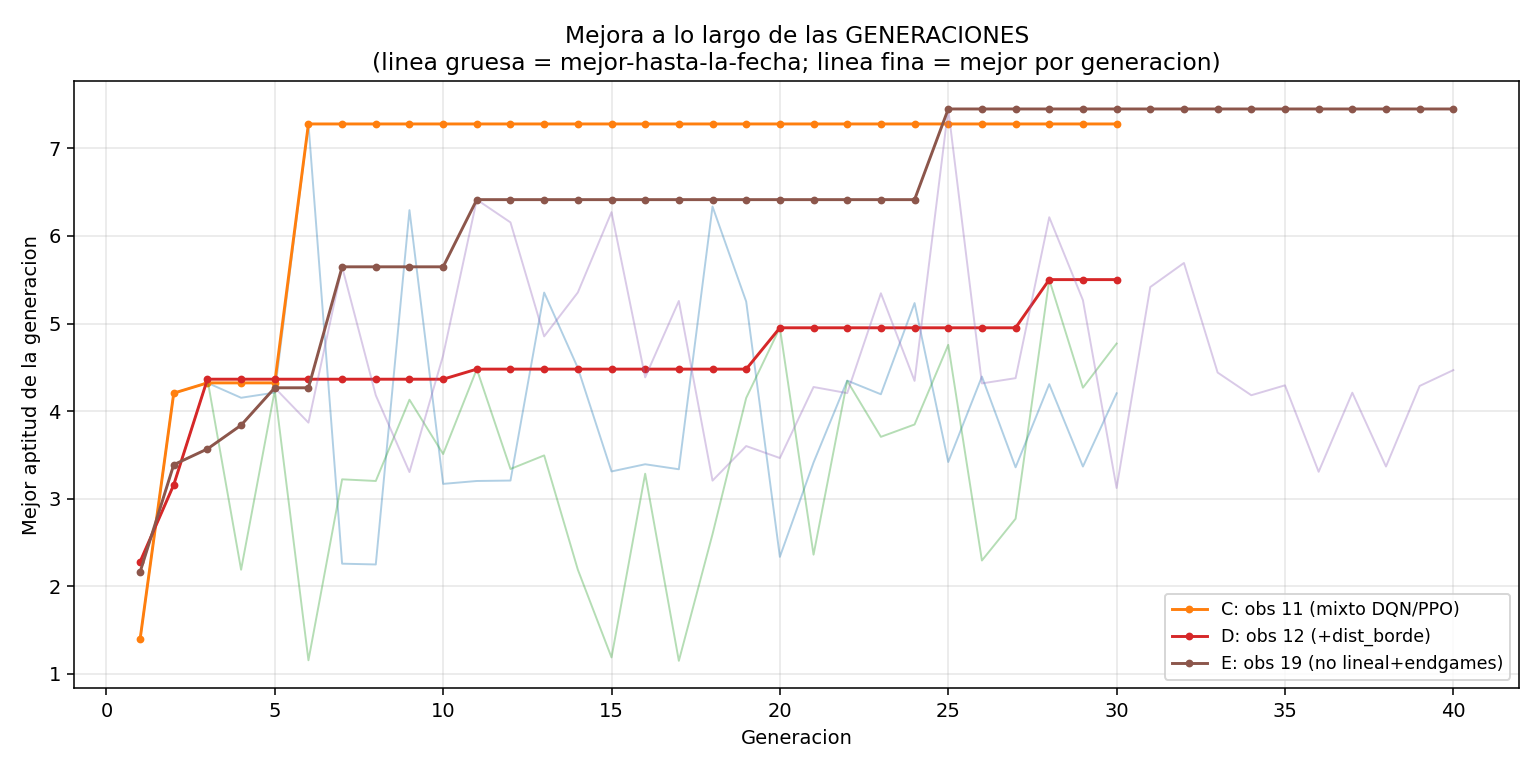
En cada generacion se evaluan los 20, se conservan los 5 mejores de cada algoritmo (10 en total), esos combaten con pares aleatorios para elegir al campeon, y a partir de ellos se crean derivados clonando los pesos y mutandolos (el hijo hereda el algoritmo del padre). La mezcla mitad DQN / mitad PPO se mantiene. En todas las corridas PPO le gano a DQN.
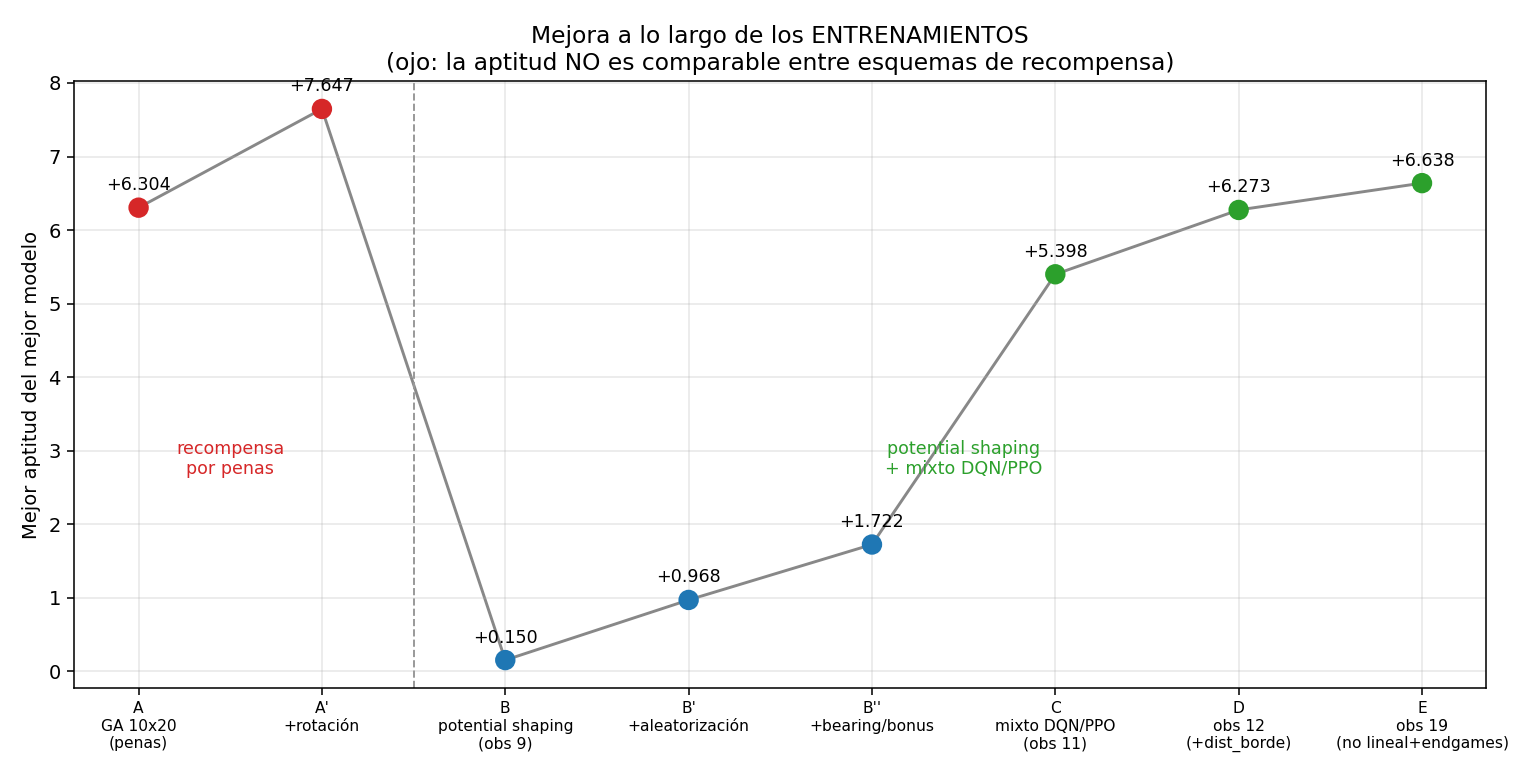
Estas fueron las corridas principales (la aptitud es la metrica interna del algoritmo, (V - D + m) = victorias menos derrotas mas margen, no es comparable entre esquemas de recompensa distintos):
| Corrida | Poblacion | Gen | Pasos/ind | Observacion | Campeon | Aptitud | Tiempo |
|---|---|---|---|---|---|---|---|
| A | 10 | 20 | 6 000 | recompensa por penas | gen8_ind2 | +6.304 | 125 s |
| A' | 10 | 20 | 6 000 | +pena por rotar | gen9_ind3 | +7.647 | 123 s |
| B | 10 | 20 | 6 000 | potential shaping (9 dims) | gen3_ind9 | +0.150 | 136 s |
| B' | 10 | 20 | 6 000 | +aleatorizacion | gen15_ind2 | +0.968 | 136 s |
| B'' | 10 | 20 | 6 000 | +bearing/bonus/acercamiento | gen2_ind6 | +1.722 | 139 s |
| C | 20 (D+PPO) | 30 | 20 000 | 11 dims | gen13_ppo_ind19 | +5.398 | 1 008 s |
| D | 20 (D+PPO) | 30 | 20 000 | 12 dims (+dist_borde) | gen9_ppo_ind12 | +6.273 | 1 027 s |
| E | 20 (D+PPO) | 40 | 25 000 | 19 dims (no lineal+endgames) | gen4_ppo_ind14 | +6.638 | 1 828 s |
Y aqui esta la evolucion en 3D (generacion x entrenamiento x aptitud), se puede rotar:
Los metodos clasicos
Para comparar implemente los metodos clasicos de minisumo sobre la misma observacion que usa la red, cada uno decide con decidir(obs, radio):
- Maquina de estados (
fsm.py): estados retractar (si se acerca al borde), atacar (si detecta al rival, lo encara y avanza) y buscar (si no lo detecta, gira). Fuente: Cytron, MTSU, Figat (2017). - PID (
pid.py): un PID sobre el error de rumbo para “encarar siempre” al oponente, con anti-windup en el integral y una reversa de seguridad cerca del borde. Fuente: ECE 470 Illinois, MIT OCW. - Logica difusa (
difuso.py): inferencia de Mamdani con dos entradas (error de rumbo y distancia), funciones de pertenencia triangulares y 9 reglas, las salidas se defuzzifican por promedio ponderado. Fuente: IJARIS 2025, ASEE NCS. - Estrategias (
estrategias.py): busqueda aleatoria, tornado (girar sobre su eje), ataque lateral (desviarse para flanquear y golpear por detras) y rastreo lento. Fuente: RTEAM, Ahmed-Maher77.
El benchmark enfrenta a PPO contra cada metodo en las dos orientaciones (para que ninguno tenga ventaja de color). Estos fueron los resultados de victorias de PPO en partidas decididas:
| Metodo | version obs 11 | version obs 19 |
|---|---|---|
| FSM | 19% (6-26) | 100% (18-0) |
| PID | 65% (40-22) | 91% (64-6) |
| Difuso | 32% (10-21) | 77% (17-5) |
| Tornado | 46% (12-14) | 80% (12-3) |
| AtaqueLateral | 36% (9-16) | 80% (8-2) |
| RastreoLento | 27% (9-24) | 83% (15-3) |
| BusquedaAleatoria | 20% (5-20) | 61% (11-7) |
| Random | — | 100% (68-0) |
| Total decididas | 39% (91-143) | 89% (213-26) |
Osea que con las mejoras (sobre todo dist_borde, la recompensa no lineal con (\gamma=0.995), el terminal (\pm 2), los giros suaves, el anti-zigzag y los endgames) el modelo paso de ganar el 39% de las partidas decididas a ganar el 89%, y las derrotas bajaron de 143 a 26. Lo que si sigue pasando es que hay muchos empates (cerca del 60%), osea el robot casi no pierde pero todavia a veces no cierra el combate dentro del tiempo.
De paso compare CPU contra GPU y resulto que la GPU es mas lenta para este proyecto (la fisica de MuJoCo corre en CPU y las redes son MLP chiquitas, asi que no vale la pena la GPU):
| Medida | CPU | GPU |
|---|---|---|
| Fisica MuJoCo | 20 940 pasos/s | — |
| Entrenar DQN | 3 178 pasos/s | 2 017 pasos/s |
| Entrenar PPO | 2 383 pasos/s | 1 139 pasos/s |
De las primeras versiones al resultado final
Antes de llegar a la version modular final fui iterando el entrenamiento y anote en cada version que fallaba y que cambiaba (cada version vivio en su propio archivo 1.py, 2.py, …):
- Primera version: use las 4 direcciones basicas y una red neuronal para decidir. Los robots se movian muy lento y se quedaban quietos en el centro, asi que agregue una penalizacion por quedarse quieto.
- Segunda: seguian quedandose en el centro, entonces agregue recompensa por moverse y por acercar al enemigo al borde.
- Tercera: ahora se alejaban entre si y no chocaban; agregue limite de tiempo, recompensa por acortar distancia y penalizacion por estar cerca del borde.
- Cuarta: se atascaban (como piezas de Tetris). Cambie las cajas por cilindros, pase a 8 direcciones (diagonales), agregue una penalizacion por estancamiento y una aparicion circular caotica. Esto funciono.
- Quinta: volvi a los cubos, deje dos direcciones en los lados para poder rotar y agregue masa y aceleracion aleatorias.
- Sexta: ya se veia mejor movimiento, planeacion y hasta roles (uno atacaba y el otro se quedaba). Pase a un solo modelo que aprende a atacar y defender, agregue el angulo del enemigo a la observacion y quite el premio constante por chocar (solo se puntua si el enemigo se aleja del centro).
- Septima: habia ataque y defensa pero se quedaban sin tiempo; baje la penalizacion por perder y subi la del tiempo para que tomaran mas riesgo.
- Octava: (sin cambios anotados).
- Novena: cambie a un algoritmo evolutivo con varias iteraciones al mismo tiempo, quite todas las recompensas menos la de ganar y cambie de PPO a DQN.
- Decima: se vio lo que parecia una pelea real, asi que aumente las iteraciones.
- Onceaba: agregue una recompensa que crece segun que tan cerca este el enemigo del borde y que baja si uno esta cerca del borde; funciono mejor con solo 15 generaciones, aunque le costaba encontrar al enemigo.
Despues de eso reescribi todo de forma modular (una carpeta src con escenario.py, agente.py, entorno.py, main.py), agregue el sensor frontal, pase la recompensa a potential shaping, normalice la observacion, sume la aleatorizacion, el dist_borde, la recompensa no lineal, los endgames y arme el algoritmo genetico mixto DQN/PPO.
Videos
Deje algunos combates grabados. Primero esta la progresion del campeon entre generaciones (los campeones intermedios de cada generacion, que fueron la semilla del siguiente, jugando contra la misma maquina de estados), y despues el campeon final contra cada metodo clasico y un self-play.
Progresion del campeon (contra maquina de estados)
Campeon contra los metodos clasicos
Campeon contra si mismo (self-play)
Conclusiones
- PPO le gano a DQN en todas las corridas; el campeon final fue una politica PPO con la mejor aptitud registrada (+6.638).
- Los cambios que mas ayudaron fueron el
dist_borde, la recompensa no lineal con \(\gamma=0.995\) y terminal \(\pm 2\), los giros suaves con anti-zigzag, los endgames y darle mas presupuesto de entrenamiento. - Contra los metodos clasicos el agente paso de ganar el 39% de las partidas decididas al 89%.
- Queda pendiente reducir los empates: el robot casi nunca pierde, pero a veces no cierra el combate dentro del tiempo. Para eso se podria penalizar mas fuerte agotar el tiempo o entrenar con un limite de tiempo mas corto.
Fuentes
- Development of an Autonomous Robot for Competitive and Educational Purposes in the Sumo Category.
- Improvement of a mobile autonomous robot to participate in sumo competitions.
- Ultra-T UERJBotzs — Mini Autonomous Sumo Robot.
- Cytron — Sumo Robot Game Strategies.
- MTSU Pressbooks — Design and Development of an Autonomous Sumo Robot.
- Figat, M. (2017) — FSM based specification of robot control system activities, IEEE.
- ECE 470 (Illinois) — Don-Bot / Katsu-Bot.
- MIT OCW — MASLAB Control.
- Development of an Intelligent Sumo Robot based on Embedded Fuzzy Logic, IJARIS 2025.
- ASEE North Central Section — Sumo Robot Competition.
- RTEAM Robotics — Sumo Bot Attack Strategies.
- Ahmed-Maher77 — Sumo-Robot.
- AIMovement — sumo.
- Sawaragi, T. (1996) — Reinforcement learning for autonomous mobile robots by Q-learning, IEEE.
- Kober, Bagnell, Peters (2013) — Reinforcement Learning in Robotics: A Survey.
- Ng, A. Y., Harada, D., Russell, S. (1999) — Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping, ICML 1999.